CDC Service の概要
CDC Service は、ソースデータベースの各変更を Kafka を通じてリアルタイムに転送し、ターゲットデータベース、検索エンジン、ストレージをソースデータベースと同期させます。何をキャプチャし、どこに配信するかは connector で指定します。
Change data capture とは
Change data capture (CDC) は、データベースで挿入、更新、削除された行を追跡し、各変更を変更イベントに変換します。CDC connector は、データベースがもともと記録しているログからこれらの変更を読み取ります。
| データベース | connector が変更を読み取る場所 |
|---|---|
| PostgreSQL | write-ahead log (WAL)。replication slot と publication を経由して読み取ります。 |
| MySQL、MariaDB | binary log (binlog)。 |
| SQL Server | SQL Server 2016 以降の Standard エディションまたは Enterprise エディションの change data capture 機能。 |
| Oracle | redo log。Oracle LogMiner を経由して読み取ります。 |
| MongoDB | oplog。 |
CDC Service の仕組み
CDC Service は Data Platform の workspace 内のサービスで、1 つの workspace に作成できる CDC Service は 1 つです。CDC Service は専用の node で connector を実行し、サービスの作成時に接続した Kafka cluster を使用します。この cluster には、FPT Database Engine の cluster か、bootstrap server endpoint を指定して設定する cluster を使用できます。
Source system → source connector → Kafka topics → sink connector → target system
source connector と sink connector
各 connector には Type と Database があります。
- source connector は、ソースシステムから変更をキャプチャし、変更イベントとして Kafka topic に書き込みます。
- sink connector は、Kafka topic を読み取り、レコードをターゲットシステム (データベース、検索エンジン、S3 ストレージなど) に書き込みます。
connector は、データを並列に処理する 1 つ以上の task を実行します。sink connector、Kafka source connector、Kafka MM2 では、task の最大数を作成時に設定します。
topic と topic prefix
source connector は、テーブルごとの変更をそれぞれ専用の Kafka topic に書き込みます。topic 名は、connector に設定した Topic prefix の後に、schema またはデータベース、テーブルが続く形式です。たとえば prefix が syncdata、schema が inventory、テーブルが customer と order の場合、PostgreSQL connector は syncdata.inventory.customer と syncdata.inventory.order に書き込みます。MongoDB では、schema とテーブルの代わりにデータベースと collection を使用します。
sink connector は、選択した topic を読み取り、各 topic をターゲットのテーブル、index、collection にマッピングします。Topic prefix、topic、Map tableを参照してください。
snapshot
変更イベントに含まれるのは、connector の実行中に行われた変更だけです。既存のデータもコピーするには、source connector で snapshot を取得します。
- Initial snapshot: connector の作成時に、Mode で動作を指定します。既存データの snapshot を取得してから変更をキャプチャする (initial)、データの snapshot だけを取得する (initial_only)、snapshot をスキップする (no_data) のいずれかです。MongoDB では、代わりに latest と copy existing を使用します。MySQL と MariaDB は一定期間が経過すると古い binlog を削除するため、これらの connector は binlog を読み取る前に、整合性のある snapshot から開始します。snapshot モードを参照してください。
- Incremental snapshot: Enable incremental snapshot を選択して作成した MySQL、MariaDB、PostgreSQL の source connector では、connector が変更の転送を続けたまま、後から connector の Snapshot メニューで snapshot を実行できます。incremental snapshot を実行するを参照してください。
Kafka MM2
Kafka MM2 (MirrorMaker 2) は、別の Kafka cluster の topic を CDC Service の Kafka cluster にコピーします。Kafka Group で選択した consumer group の offset もコピーするため、これらの consumer は CDC Service の cluster に移行し、中断した位置から処理を続行できます。Kafka MM2 は、サービスの Kafka MM2 タブで Create Kafka MM2 を選択して作成します。Kafka MM2 source を管理するを参照してください。
Kafka source connectorも別の Kafka cluster の topic を CDC Service の cluster にコピーしますが、コピーするのは topic のデータだけです。データだけが必要な場合は Kafka source connector を、topic を consumer とともに移行する場合は Kafka MM2 を使用します。
どちらも、Default Replication Policy ではコピーした topic に CLUSTER_ALIAS.TOPIC という名前を付け、Identity Replication Policy では元の topic 名をそのまま使用します。
connector の状態
- Running: connector は実行中で、データを処理しています。
- Paused: connector はデータを処理しませんが、状態と設定を保持しています。再開できます。
- Stopped: connector とその task はシャットダウンされています。connector は設定と offset を保持しているため、再開できます。
- Failed: connector でエラーが発生し、データの処理を続行できません。
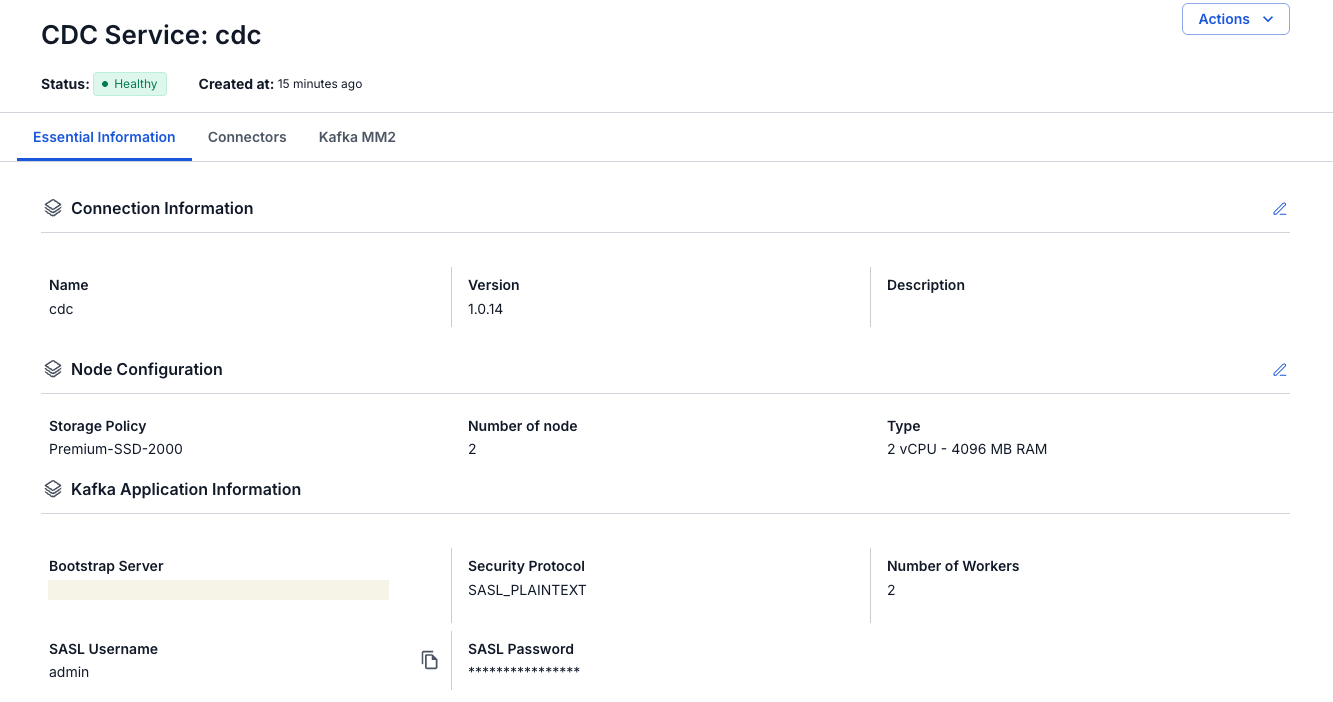
これらは connector の状態です。Healthy は CDC Service 自体のステータスです。
状態を変更する方法については、connector の状態を管理するを参照してください。
サポートされている connector
| システム | Source connector | Sink connector |
|---|---|---|
| PostgreSQL | PostgreSQL source | PostgreSQL sink |
| MySQL | MySQL source | MySQL sink |
| MariaDB | MariaDB source | MariaDB sink |
| SQL Server | SQL Server source | SQL Server sink |
| Oracle | Oracle source | – |
| MongoDB | MongoDB source | MongoDB sink |
| Kafka | Kafka source | – |
| S3 | S3 source | S3 sink |
| ClickHouse | – | ClickHouse (logs) sink: 事前に作成したテーブルに、すべての変更を新しい行として追加します。ClickHouse (Replication) sink: こちらも事前に作成したテーブルで、各行の現在の状態を保持します。 |
| Iceberg | – | Iceberg sink: ソースデータベースの更新と削除を反映します。Iceberg (logs) sink: すべてのレコードを追記します。 |
| OpenSearch | – | OpenSearch sink |
| Elasticsearch | – | Elasticsearch sink |
| Redis | – | Redis sink |
Kafka source connector は、別の Kafka cluster の topic を CDC Service の cluster にコピーします。S3 source connector は、Amazon S3 または S3 互換ストレージ (FPT Object Storage など) から、CSV、TSV、Avro、XML などのファイルを読み取ります。
一般的なワークフロー
- workspace に CDC Service を作成し、Kafka cluster に接続します。
- ソースデータベースを準備し、source connector (例: PostgreSQL source connector) を作成します。
- source connector の topic を読み取る sink connector (例: PostgreSQL sink connector) を作成します。
- Connectors タブで、connector の Status と Snapshot Status を確認します。connector の詳細を表示するとincremental snapshot を実行するを参照してください。