PostgreSQL source connector を作成する
PostgreSQL のテーブルで発生するすべての行の変更を Kafka topic にストリーミングし、sink connector で他のシステムに配信できるようにします。connector は、pgoutput プラグインを使用した論理レプリケーションで write-ahead log (WAL) を読み取ります。
前提条件
- ステータスが Healthy の CDC Service があること。CDC Service を作成するを参照してください。
- プライマリの PostgreSQL サーバーに superuser としてアクセスできること。CDC はプライマリで実行され、ホットスタンバイやウォームスタンバイの replica では実行されません。
- PostgreSQL データベースを準備するの説明に従って、データベースが CDC 用に準備されていること。
PostgreSQL データベースを準備する
以下のステートメントを、superuser としてプライマリサーバーで実行します。
-
wal_levelを確認し、logical以外の場合はlogicalに設定します。SHOW wal_level;ALTER SYSTEM SET wal_level = 'logical'; -
新しい
wal_levelを有効にするため、PostgreSQL サービスを再起動します。wal_levelがすでにlogicalの場合、この手順は省略します。警告プライマリサーバーを再起動すると、データベースを使用しているアプリケーションが中断されます。再起動はメンテナンスウィンドウ中に計画してください。
-
connector が接続に使用する、
REPLICATIONrole を持つユーザーを作成します。既存の superuser も使用できます。CREATE USER YOUR_USER WITH REPLICATION LOGIN PASSWORD 'YOUR_PASSWORD';既存のユーザーが superuser かどうかを確認するには、
SELECT rolsuper FROM pg_roles WHERE rolname = 'YOUR_USER';を実行します。 -
connector のユーザーが superuser でない場合は、キャプチャするテーブルの publication を作成します。Publication name フィールドには英小文字と数字しか入力できないため、名前は英小文字と数字のみで付けてください。
-- All tablesCREATE PUBLICATION YOUR_PUBLICATION FOR ALL TABLES;-- Or only some tablesCREATE PUBLICATION YOUR_PUBLICATION FOR TABLE YOUR_SCHEMA.YOUR_TABLE, YOUR_SCHEMA.OTHER_TABLE;superuser の場合、この手順は省略できます。その場合は、Publication name に入力した名前で、connector がすべてのテーブルを対象とする publication を作成します。
-
キャプチャするテーブルに対する
SELECT権限を、connector のユーザーに付与します。ユーザーが superuser の場合、この手順は省略します。GRANT SELECT ON TABLE YOUR_SCHEMA.YOUR_TABLE TO YOUR_USER;schema 内のすべてのテーブルに
SELECT権限を付与するには、次のステートメントを実行します。DO $$DECLAREtable_record RECORD;BEGINFOR table_record INSELECT table_nameFROM information_schema.tablesWHERE table_schema = 'YOUR_SCHEMA' AND table_type = 'BASE TABLE'LOOPEXECUTE 'GRANT SELECT ON TABLE YOUR_SCHEMA."' || table_record.table_name || '" TO YOUR_USER';END LOOP;END $$; -
Enable incremental snapshot を選択する予定の場合は、ユーザーが signal テーブル
public.cdc_signalを作成し、書き込めるようにします。このテーブルは connector の作成時に作成され、snapshot はこのテーブルを通じて実行されます。GRANT USAGE, CREATE ON SCHEMA public TO YOUR_USER;-- If public.cdc_signal already exists, for example from another connectorGRANT INSERT ON public.cdc_signal TO YOUR_USER;publication でテーブルを個別に指定している場合は、connector の作成後に
public.cdc_signalを publication に追加します。publication のテーブルを変更するを参照してください。 -
変更イベントに変更前と変更後の行の値が含まれるように、キャプチャする各テーブルに
REPLICA IDENTITY FULLを設定します。ALTER TABLE YOUR_SCHEMA.YOUR_TABLE REPLICA IDENTITY FULL;schema 内のすべてのテーブルを変更するには、次のステートメントを実行します。
DO $$DECLAREtable_record RECORD;BEGINFOR table_record INSELECT table_nameFROM information_schema.tablesWHERE table_schema = 'YOUR_SCHEMA' AND table_type = 'BASE TABLE'LOOPEXECUTE 'ALTER TABLE YOUR_SCHEMA."' || table_record.table_name || '" REPLICA IDENTITY FULL';END LOOP;END $$; -
heartbeat テーブルを作成します。Heartbeat interval (ms) が
0より大きい場合、connector はこのテーブルに heartbeat を書き込みます。デフォルトは0で、この場合 heartbeat は送信されません。CREATE TABLE IF NOT EXISTS public.cdc_heartbeat (id integer PRIMARY KEY,last_heartbeat timestamptz NOT NULL); -
サーバーに replication slot をもう 1 つ作成する余裕があることを確認します。connector は Slot name に入力した名前で slot を作成するか、同じ名前の既存の slot を再利用します。
SHOW max_replication_slots;SELECT slot_name, plugin, slot_type, database, active FROM pg_replication_slots;アクティブではなくなった slot を解放するには、
SELECT pg_drop_replication_slot('YOUR_SLOT');を実行します。上限を引き上げるには、postgresql.confのmax_replication_slotsを変更します。
publication のテーブルを変更する
テーブルを列挙して publication を作成した場合は、キャプチャするテーブルが変わるたびに、superuser として次のステートメントを実行します。
-- List the publications
SELECT * FROM pg_publication;
-- Add tables
ALTER PUBLICATION YOUR_PUBLICATION ADD TABLE YOUR_SCHEMA.YOUR_TABLE;
-- Remove tables
ALTER PUBLICATION YOUR_PUBLICATION DROP TABLE YOUR_SCHEMA.YOUR_TABLE;
connector を作成する
-
Data platform → Workspace management を選択し、workspace を選択します。
-
Overview タブの Services で、CDC カードを選択します。
-
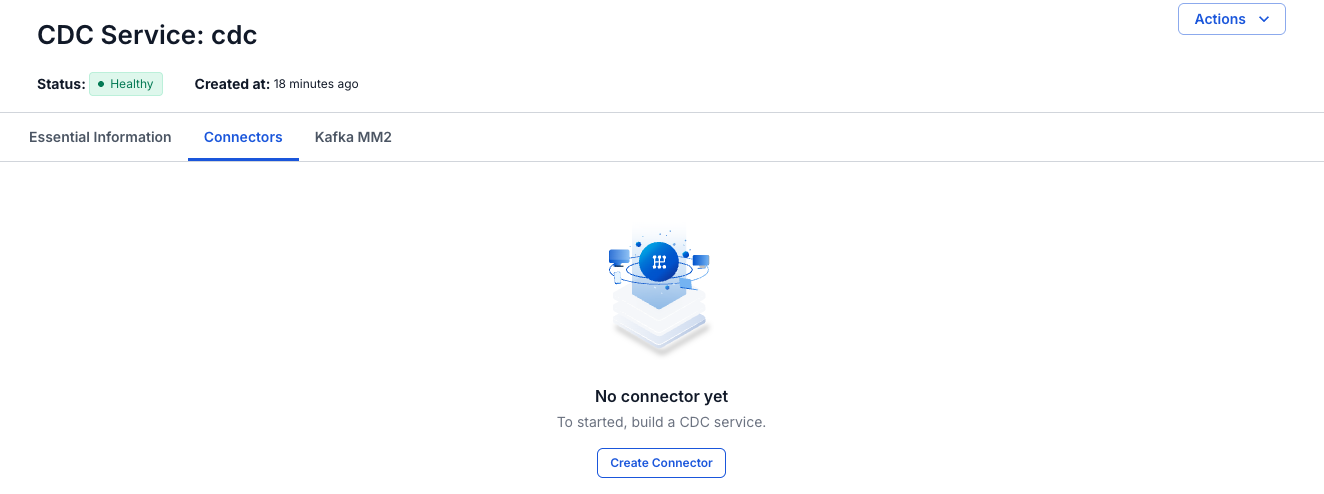
Connectors タブを選択し、Create Connector を選択します。
-
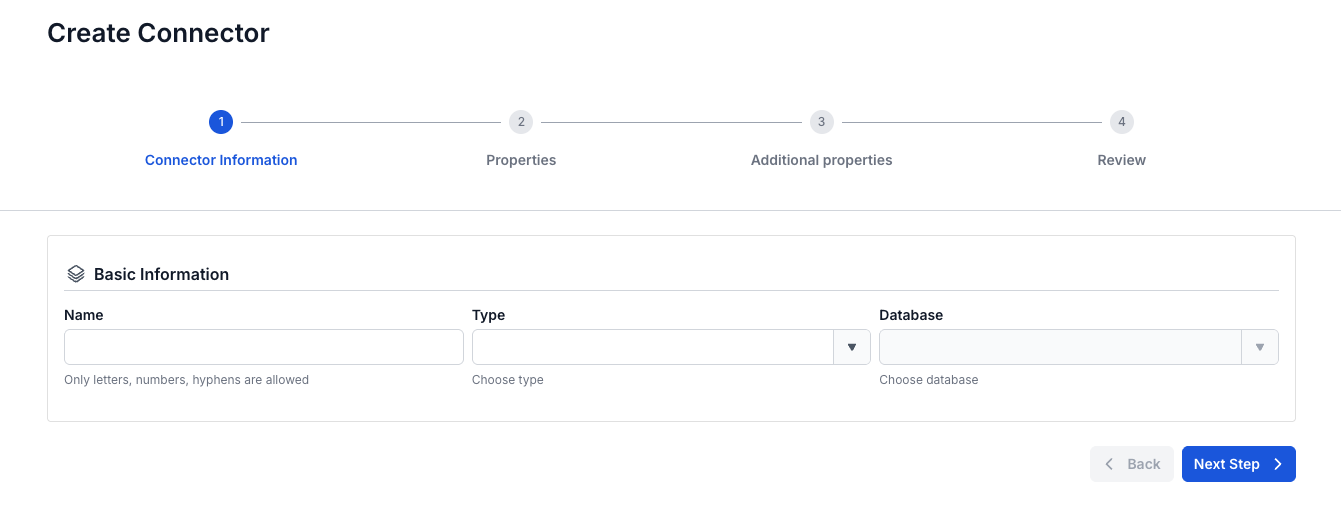
Connector Information 画面で Name を入力し、Type で source、Database で PostgreSQL を選択します。
-
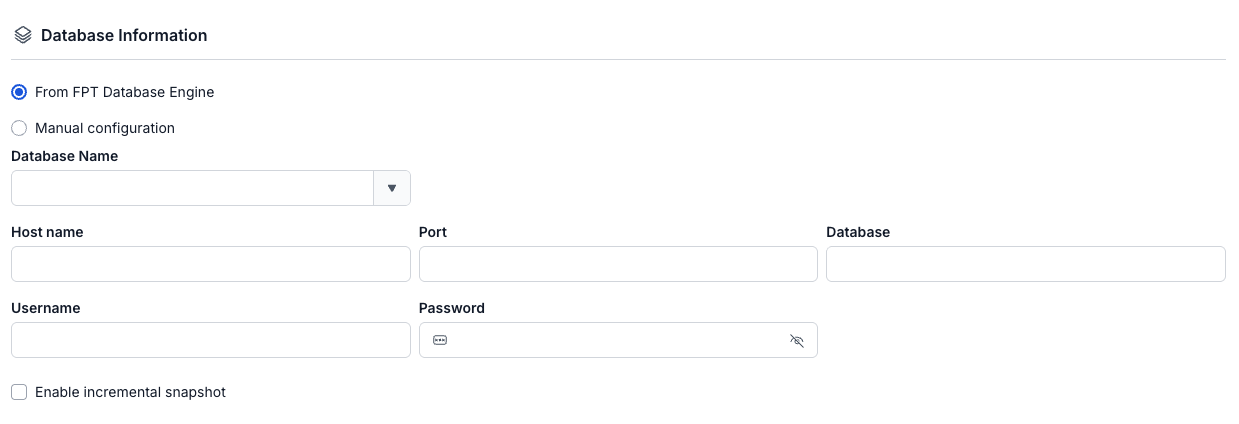
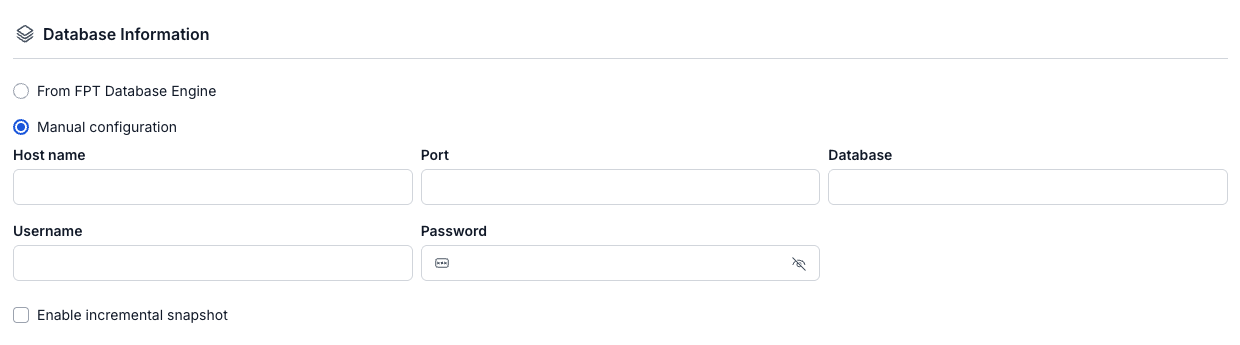
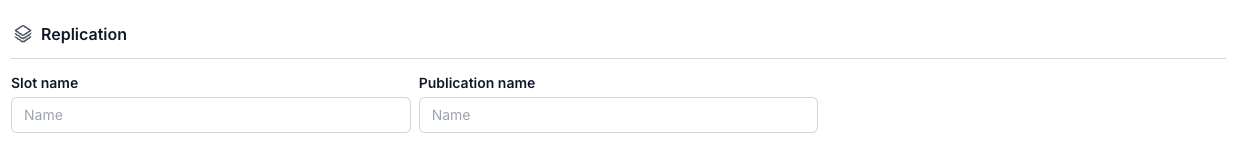
Next Step を選択します。Properties 画面で接続情報、Topic prefix、slot 名、publication 名を入力し、Test connection を選択します。テストに成功して「Connect Successfully」というメッセージが表示されると、Next Step を選択できるようになります。

-
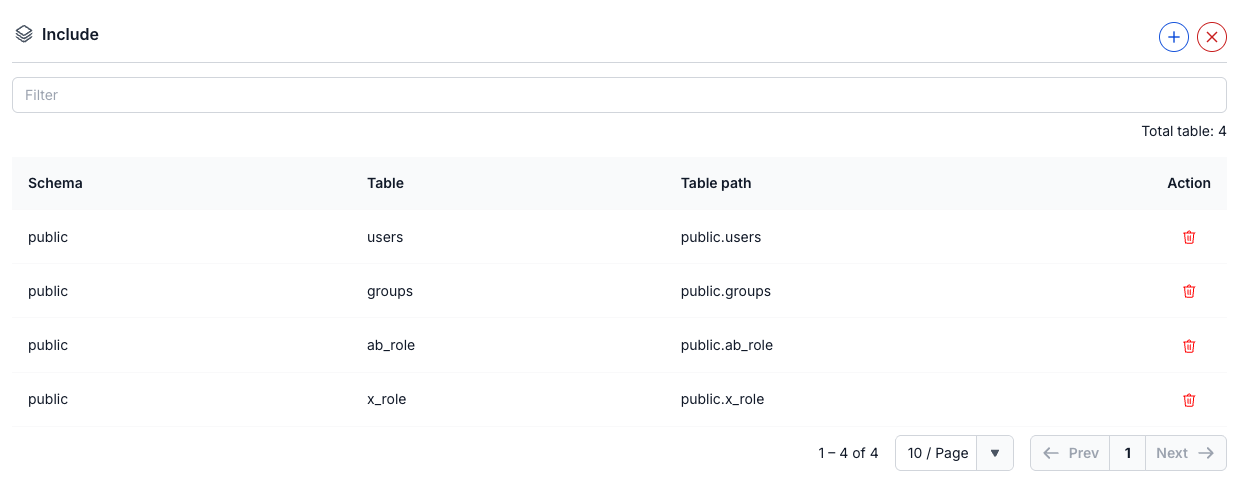
Next Step を選択します。Additional properties 画面で snapshot の Mode を選択し、キャプチャするテーブルを追加して、Heartbeat interval (ms) を設定します。

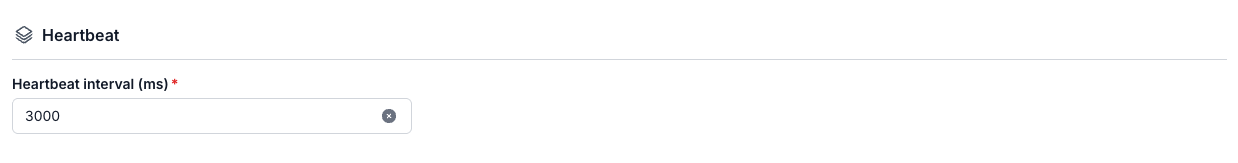
-
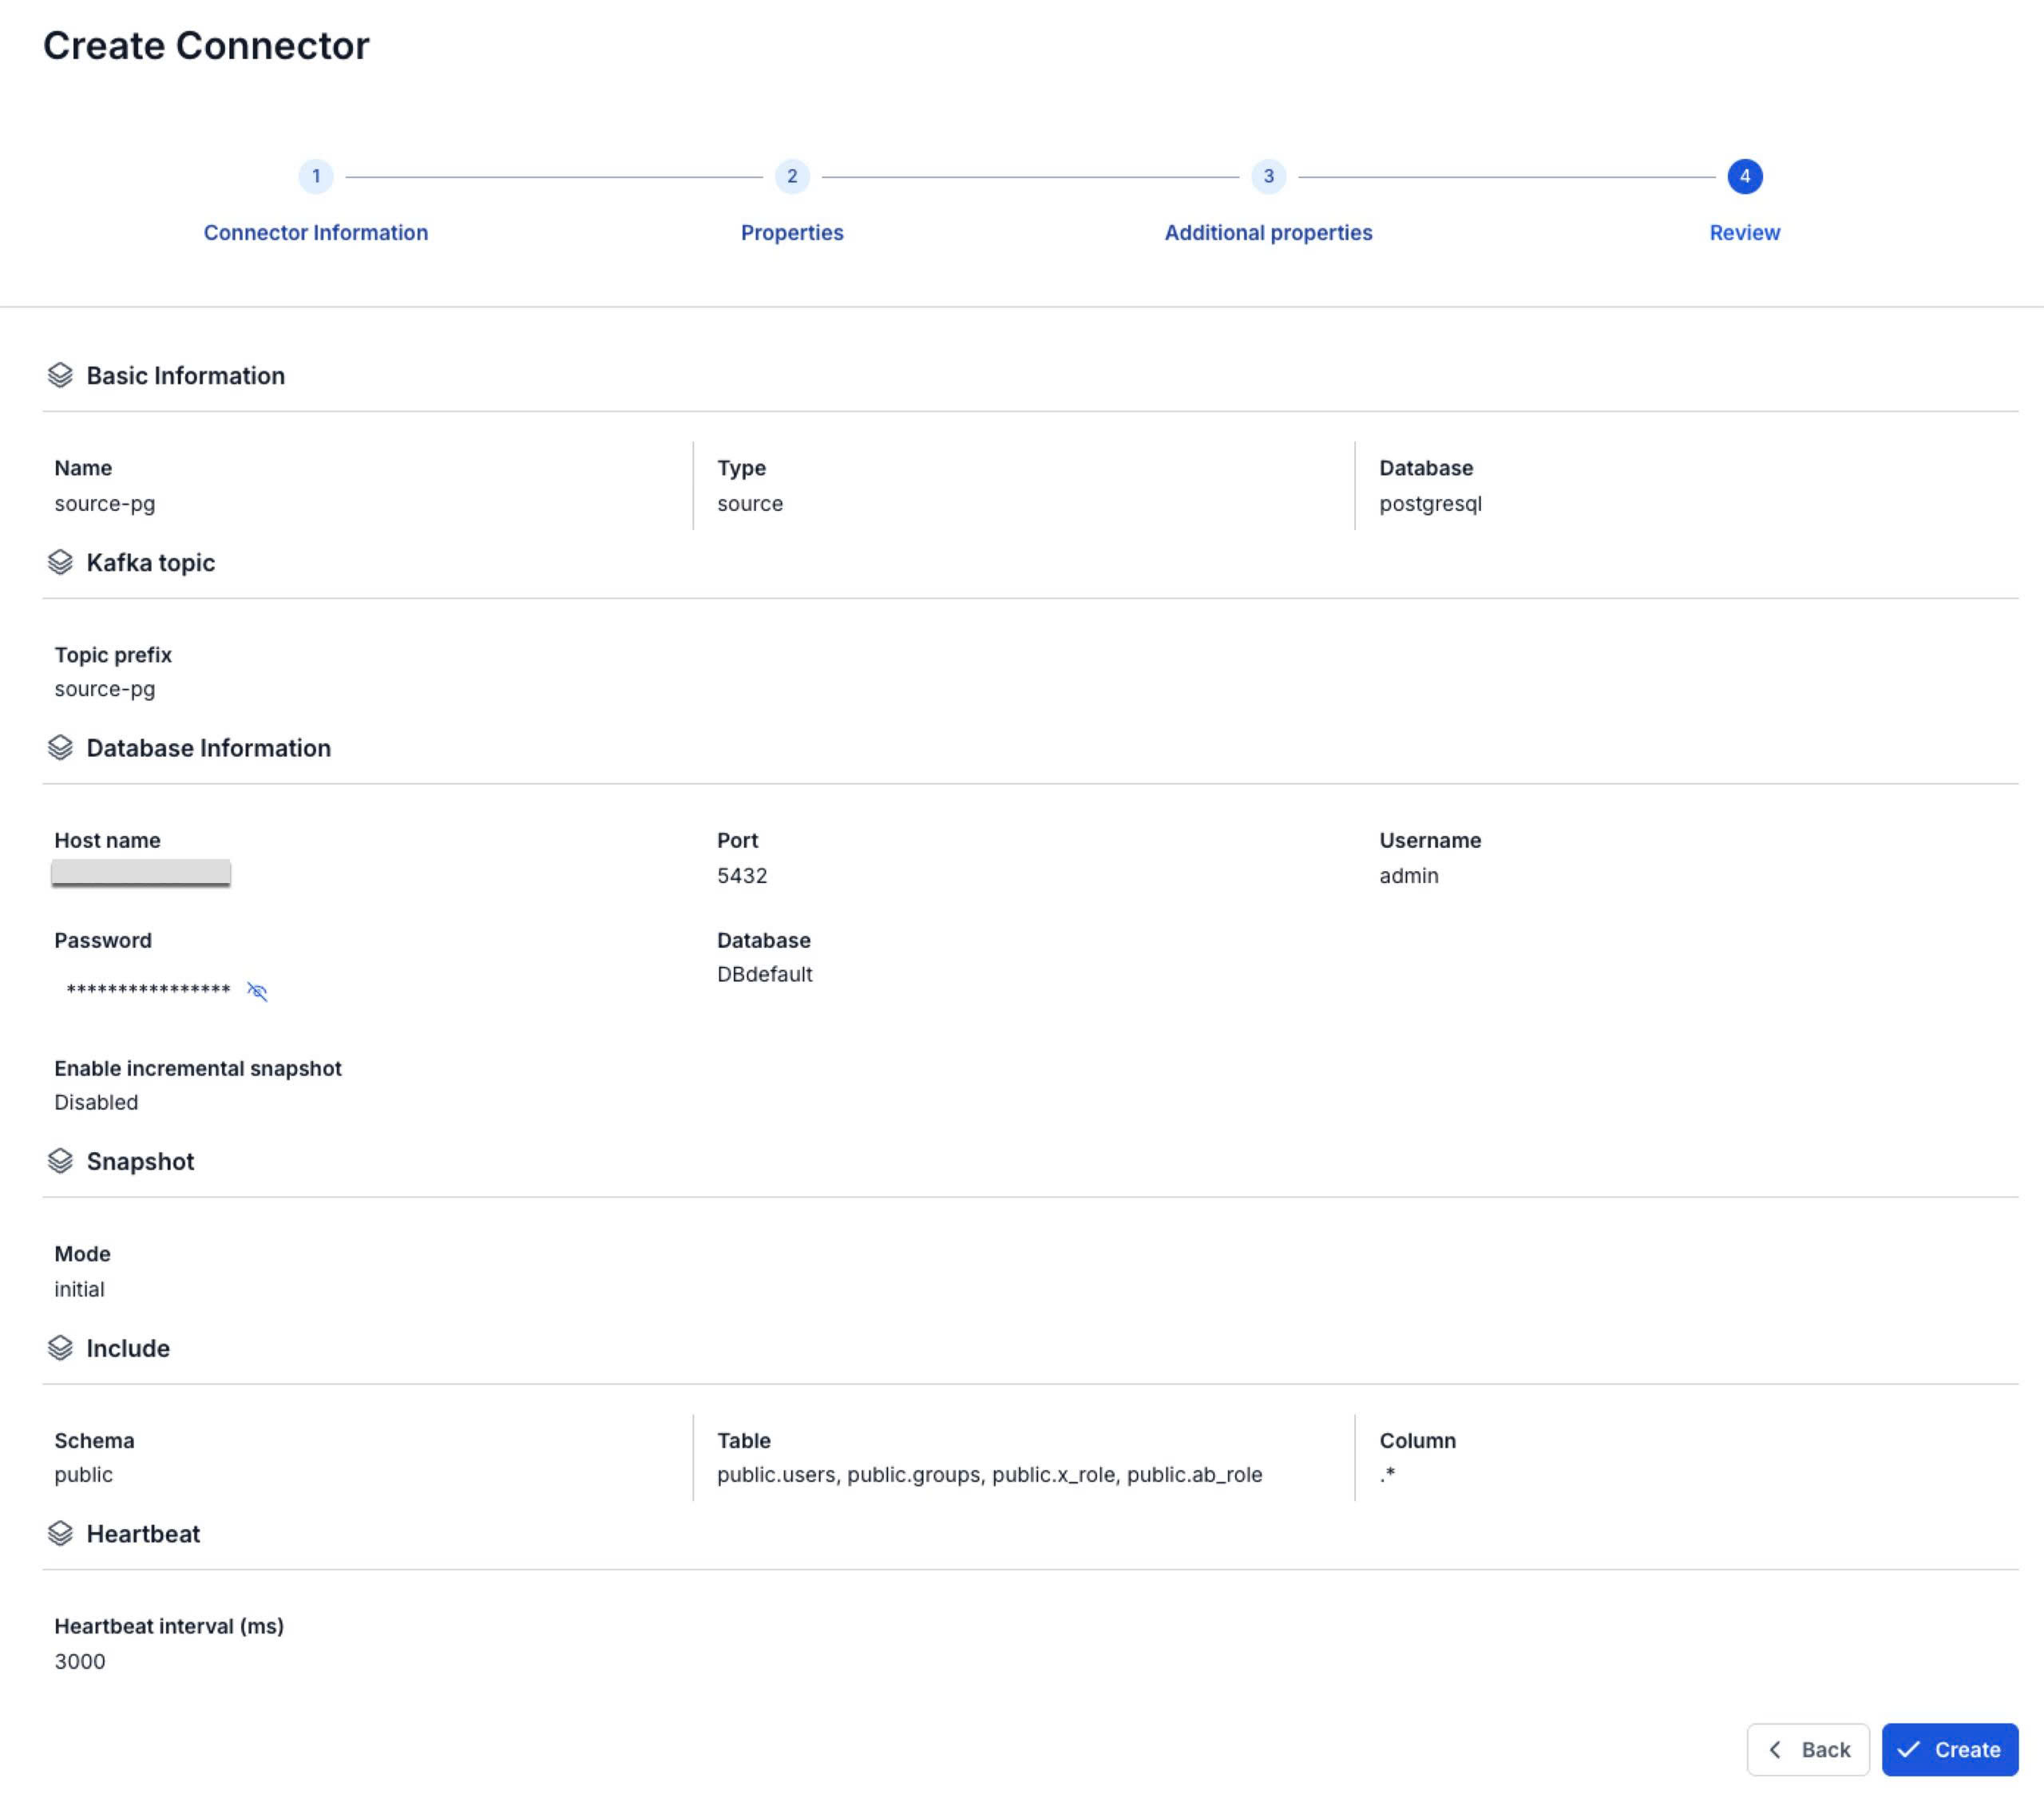
Next Step を選択し、Review 画面で設定を確認します。
-
Create を選択します。
ポータルに「Create Successfully」と表示され、CDC Service の Essential Information タブが開きます。Connectors タブでは、新しい connector が Running と表示され、task が開始されるまで Tasks のカウンターはすべて
0のままです。task の開始には最大で約 2.5 分かかります。Snapshot Status は、incremental snapshot を実行するまで Not Started と表示されます。
connector の設定
Connector Information 画面
| フィールド | 必須 | 説明 |
|---|---|---|
| Name | はい | connector の名前です。英小文字、数字、ハイフン (-) を使用できます。英大文字、_、.、スペースを含めると、「Name has invalid characters」というエラーが表示されます。 |
| Type | はい | source を選択します。 |
| Database | はい | PostgreSQL を選択します。 |
Properties 画面
| フィールド | 必須 | 説明 |
|---|---|---|
| From FPT Database Engine / Manual configuration | はい | FPT Database Engine の PostgreSQL instance を選択するか、接続情報を自分で入力します。デフォルトでは Manual configuration が選択されています。接続モードを参照してください。 |
| Database Name | From FPT Database Engine の場合 | FPT Database Engine の PostgreSQL instance です。一覧には、Lakehouse が作成した instance も表示されます。instance を選択すると Host name と Port が自動入力されます。自動入力された値は編集できます。Database、Username、Password は空のままです。 |
| Host name | はい | PostgreSQL サーバーのホスト名または IP アドレスです。 |
| Port | はい | PostgreSQL サーバーのポートです (例: 5432)。Manual configuration では、このフィールドにデフォルト値はありません。 |
| Database | はい | 変更をキャプチャするデータベースです。 |
| Username | はい | 手順 3 で準備したユーザーです。 |
| Password | はい | ユーザーのパスワードです。 |
| Enable incremental snapshot | いいえ | この connector で incremental snapshot を実行できるようにします。選択すると、connector の作成時に signal テーブル public.cdc_signal も作成され、Test connection で CREATE TABLE と INSERT の権限が確認されます。signal テーブル用の topic TOPIC_PREFIX.public.cdc_signal も作成されます。このオプションを選択しない場合は signal テーブルがないため、メニューに Snapshot → Execute が表示されていても実行できません。Incremental snapshotを参照してください。 |
| Topic prefix | はい | connector の書き込み先となる Kafka topic のプレフィックスです。テーブルごとの topic 名は TOPIC_PREFIX.SCHEMA.TABLE です (例: syncdata.inventory.customer)。Topic prefixを参照してください。 |
| Slot name | はい | connector が読み取る replication slot です。英小文字と数字のみ使用できます。_ などその他の文字を含めると、「Slot name has invalid characters」というエラーが表示されます。connector はこの名前で slot を作成するか、同じ名前の既存の slot を再利用します。 |
| Publication name | はい | 手順 4 で作成した publication です。superuser の場合は、connector が作成する publication の名前です。英小文字と数字のみ使用できます。_ などその他の文字を含めると、「Publication name has invalid characters」というエラーが表示されます。 |
Additional properties 画面
| フィールド | 必須 | 説明 |
|---|---|---|
| Mode | はい | 既存の行に対する connector の処理です。このフィールドにはデフォルト値がないため、いずれかを選択します。initial は既存の行の snapshot を取得してから、変更をキャプチャします。initial_only は snapshot を取得するだけで、変更はキャプチャしません。no_data は新しい変更だけをキャプチャします。snapshot モードを参照してください。 |
| Include | いいえ | キャプチャするテーブルです。+ を選択してデータベースの schema とテーブルを読み込み、テーブルを最大 100 個選択します。一覧の検索には Filter を、テーブルの削除には削除アイコンを使用します。テーブルを追加しない場合、connector はすべてのテーブルをキャプチャします。 |
| Heartbeat interval (ms) | はい | heartbeat メッセージの送信間隔です。0〜30000 の範囲で指定します。デフォルトは 0 で、この場合 heartbeat は送信されません。connector は手順 8 で作成したテーブルに heartbeat を書き込みます。Heartbeatを参照してください。 |
connector の削除後にクリーンアップする
PostgreSQL source connector を削除しても、その replication slot と publication はデータベースに残ります。
replication slot を削除するまで、PostgreSQL は slot がまだ消費していない WAL をすべて保持するため、ディスク使用量が増え続けます。
superuser として slot と publication を削除します。
SELECT pg_drop_replication_slot('YOUR_SLOT');
DROP PUBLICATION YOUR_PUBLICATION;