特定時点への復旧
Point-in-time recovery は、選んだ時点のデータを秒単位で再現します。時刻が特定できる障害、たとえば失敗したマイグレーションや誤った DELETE の後で、スケジュールされた backup まで戻すとそれ以降のデータをすべて失ってしまう場合に使います。
仕組みは full backup の上に archived log を再適用するもので、そのため戻したい時点より前に両方が揃っている必要があります。
対応するのは PostgreSQL、MySQL、MariaDB のみです。他の engine では backup からの restore が復旧手段になりますが、Kafka と RabbitMQ には backup も restore もありません。
この操作は新しい database を作成します。既存の database を上書きしないため、追加の quota を見込み、完了後にアプリケーションの接続情報を更新してください。
前提条件
- database で PITR が有効になっていること。PITR の有効化と無効化 を参照してください。
- PITR を有効にした後に取得された full backup が 1 つ以上あること。
- 目的の時点をカバーする archived log が利用できること。
- 2 つ目の database を作成できる quota が残っていること。特定時点への復旧では新しい database が作られ、元の database はそのまま稼働し続けるためです。
復旧を実行する
-
database ID をクリックし、Backup タブ、続いて Restore サブタブを開きます。
-
Recover to point in time をクリックします。
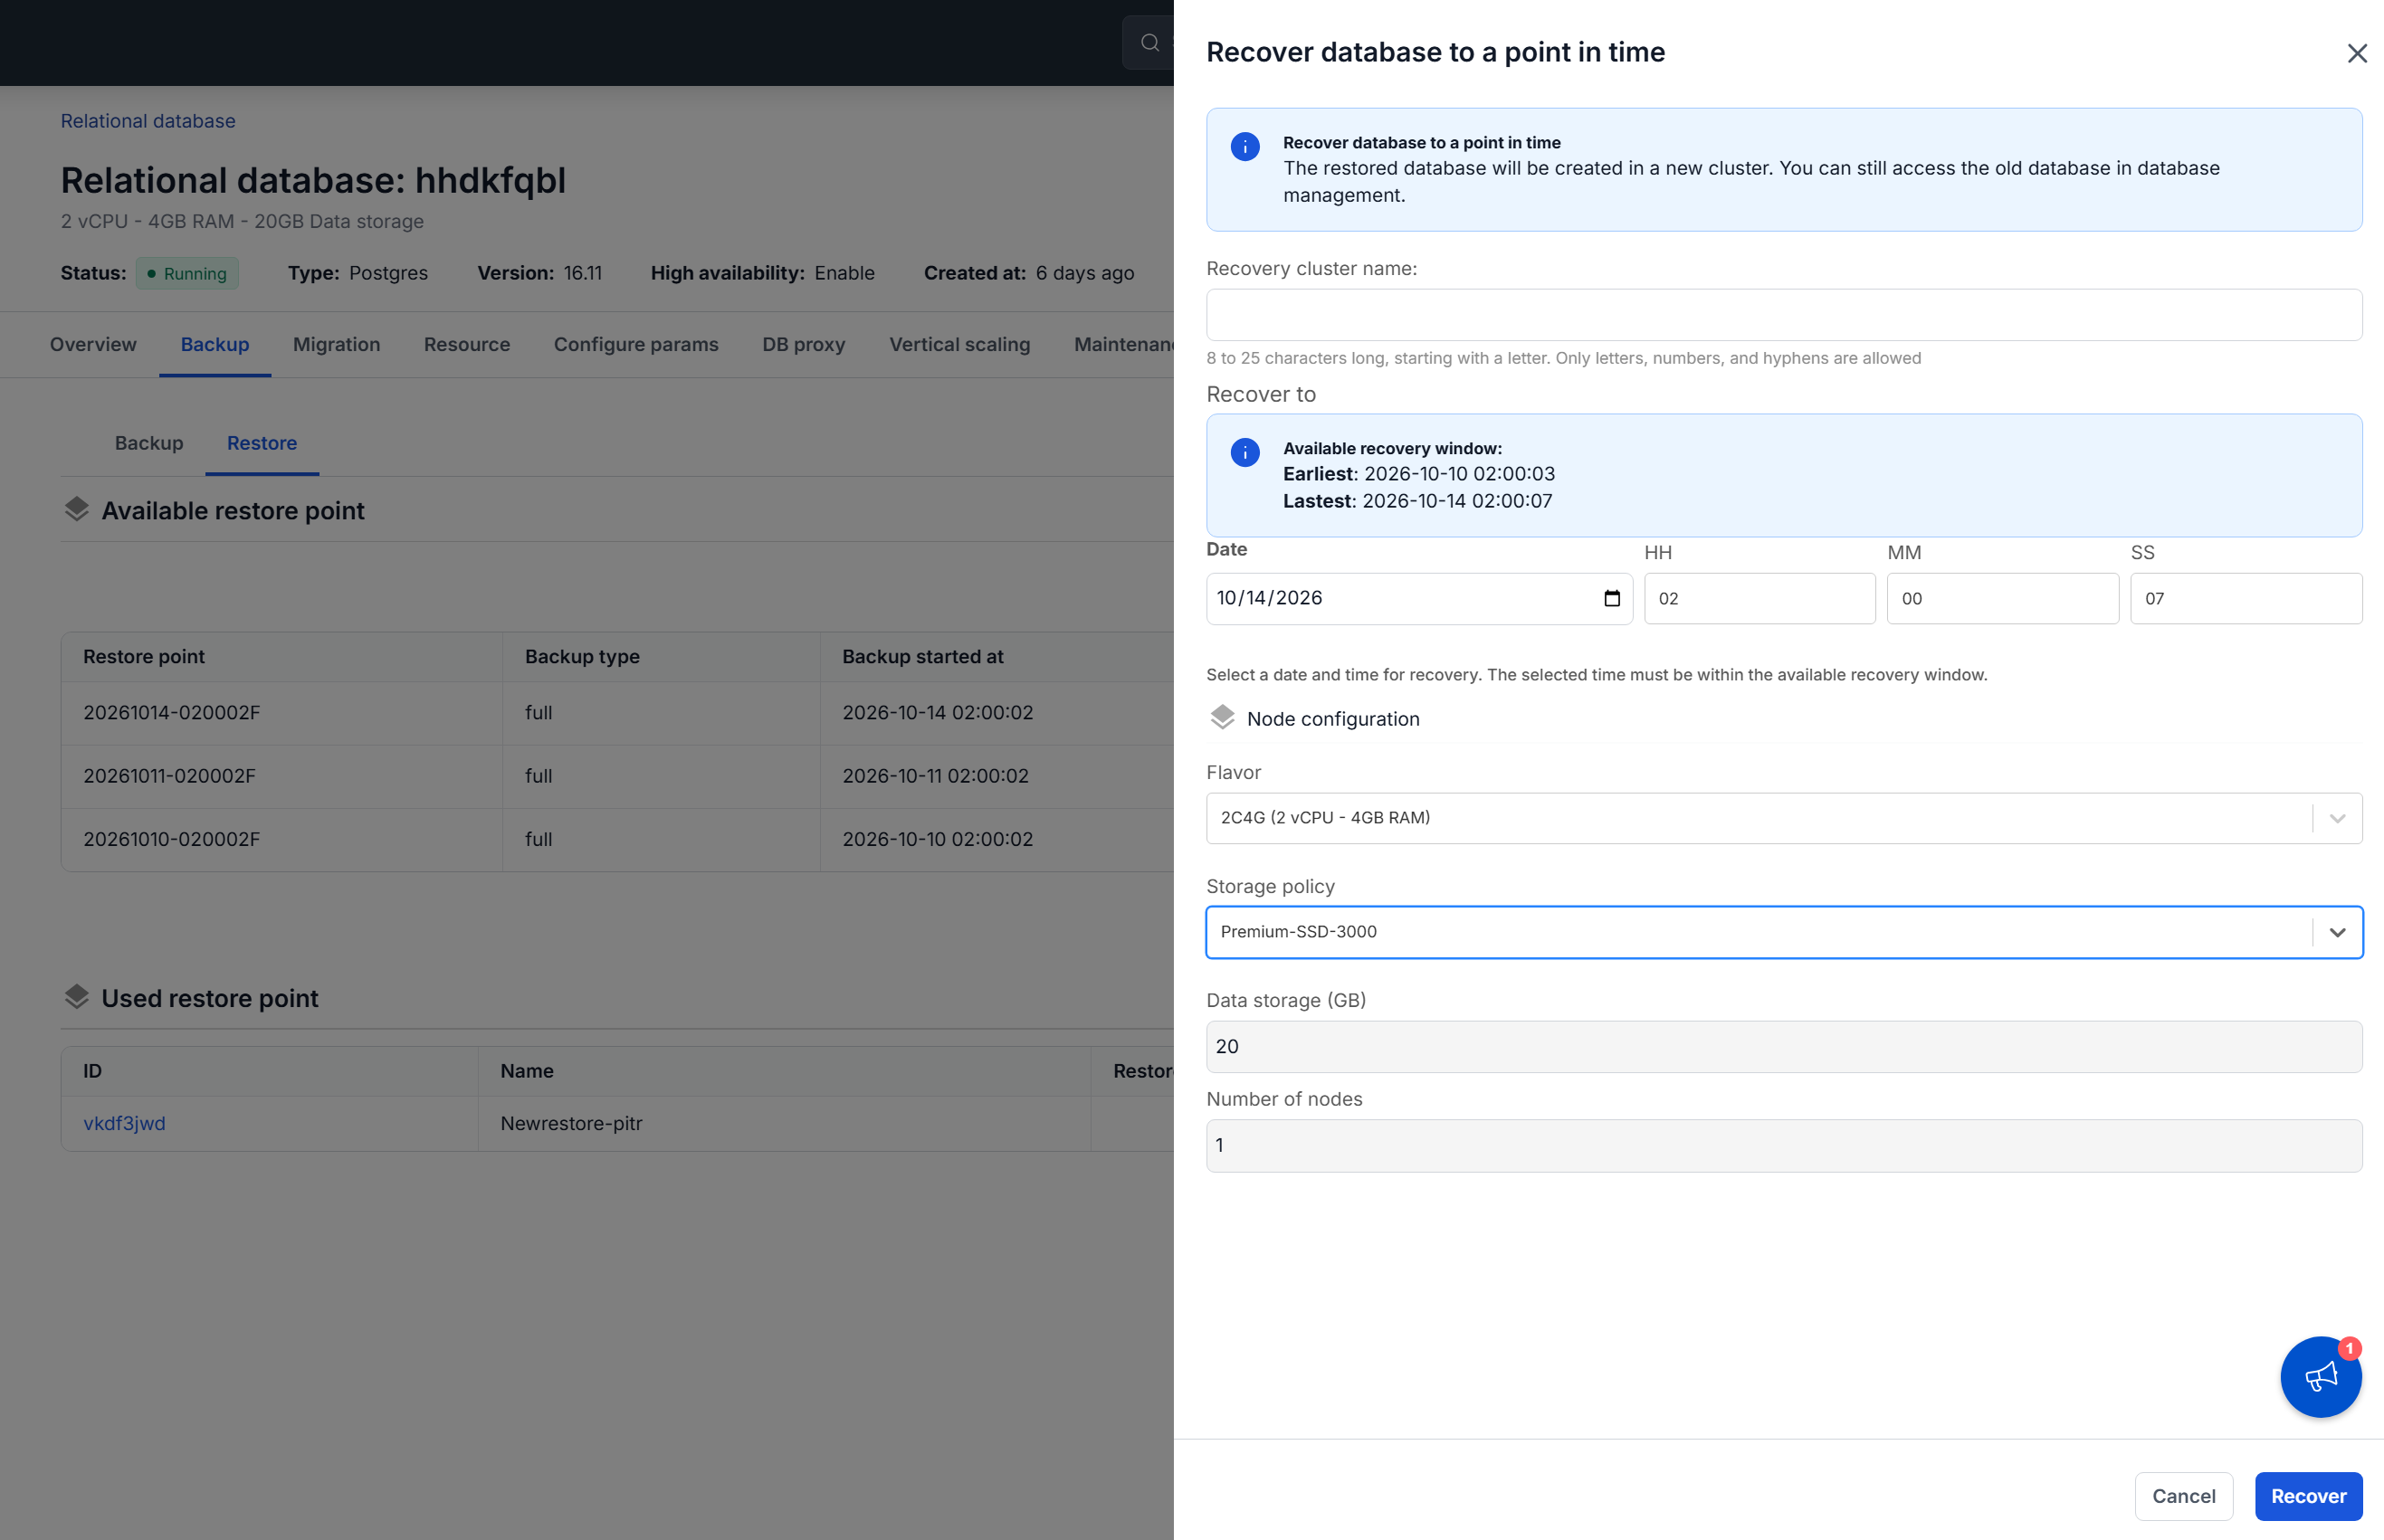
-
ダイアログは元の database の構成で開きます。各項目を入力してください。
- Recovery cluster name: 新しい database の名前です。8〜25 文字、先頭は英字、使えるのは英字、数字、ハイフンのみです。
- Recover to: 戻したい時点を、日付と時、分、秒で指定します。入力欄の上に Available recovery window として選択可能な最も早い時点と最も遅い時点が表示され、その範囲外の時刻は受け付けられません。
- Flavor: 新しい database のコンピュート構成です。
- Storage policy: IOPS 性能を決める policy です。
- Data storage (GB) と Number of nodes は元の database から引き継がれ、読み取り専用で表示されます。
-
Recover をクリックします。
その時点のデータを持つ新しい database が作成されます。
戻せるのは、PITR を有効化した後に実行された最初の full backup より後の時点だけです。その backup が完了するまで PITR は利用できず、それ以前の変更は復旧できません。PITR を有効にした時点が保護の開始点ではありません。
復旧する時点の選び方
問題に気付いた時刻ではなく、データが正しいと確信できる最後の時点を選んでください。この 2 つが一致することはまれで、後者を選ぶと問題ごと復旧してしまいます。
判断がつかない場合は、候補の時刻で復旧し、新しい database に接続して内容を確認してください。この操作は元の database に影響しないため、別の時刻で何度でもやり直せます。
次のステップ
- Floating IP で database に接続する。トラフィックを切り替える前に復旧したデータを確認します
- PITR の有効化と無効化。復旧できる retention の範囲を確認します
- database の停止・起動・再起動。置き換えた database を削除します