Thêm Worker Group dùng GPU (RTX PRO 6000)
NVIDIA RTX PRO 6000 Blackwell là một trong các GPU flavor có thể chọn khi bạn đặt Instance Type của Worker Group là GPU, bên cạnh NVIDIA Tesla A30, NVIDIA Tesla A100, FPT GPU L4 - 24G (beta), và NVIDIA H100 SXM5. Trang này nói về phần khác biệt khi cấu hình Worker Group dùng GPU — xem Thêm Worker Group để biết các bước cơ bản (mở Node Pools, chọn Edit Workers, điền các field chung), và Tạo cluster Kubernetes mới nếu bạn chọn GPU flavor ngay khi tạo cluster mới.
RTX PRO 6000 Blackwell yêu cầu cluster chạy Kubernetes v1.33 trở lên. Với cluster phiên bản thấp hơn, tùy chọn này không xuất hiện trong danh sách GPU Type — xem Nâng cấp phiên bản Kubernetes.
RTX PRO 6000 Blackwell chỉ có ở Worker Group thêm mới, không có ở base Worker Group (Worker group 1) — danh sách GPU Type cho base group chỉ gồm Tesla A30, Tesla A100, và FPT GPU L4.
Bước 1: Xem lại GPU Information ở Basic information
Mục GPU Information nằm ở bước Basic information, có sẵn ngay từ đầu — bạn không cần cấu hình Worker Group dùng GPU trước. Mặc định mục này đang tắt.
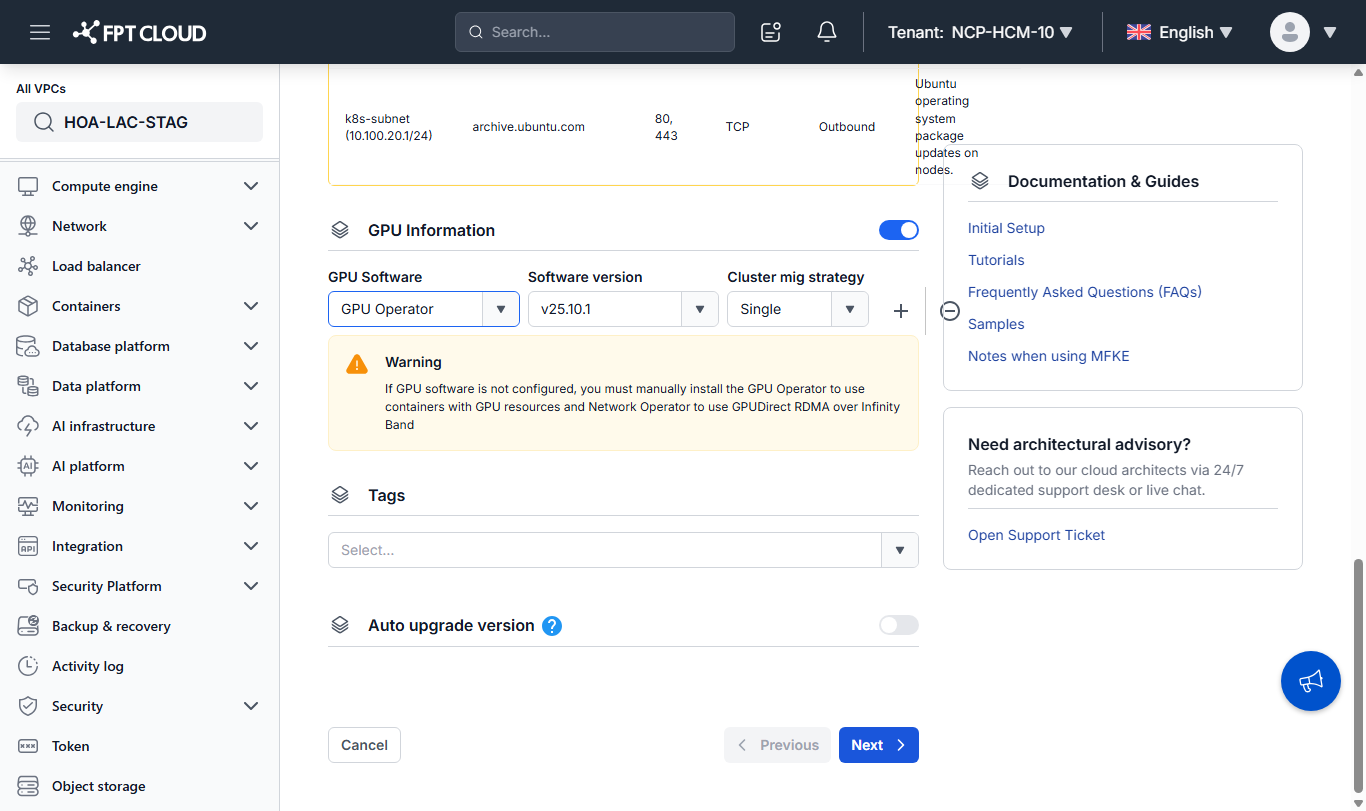
- Nếu bạn định dùng Managed-install cho GPU driver của Worker Group (xem Bước 2), bật GPU Information ở bước Basic information.
- Chọn các mục GPU Software cần dùng — GPU Operator, Network Operator, Slurm Operator, hoặc vGPU Scheduler — mỗi mục có Software version riêng. Chọn + để thêm mục khác. Với GPU Operator, điền thêm Cluster mig strategy (ví dụ Single).
Nếu tắt GPU Information, container không dùng được tài nguyên GPU cho tới khi bạn tự cài GPU Operator — và tự cài Network Operator nếu cần GPUDirect RDMA qua InfiniBand.
Bước 2: Cấu hình Worker Group dùng GPU
Vào bước Node pools. Trên Worker Group bạn đang thêm hoặc sửa:
- Đặt Instance type là GPU.
- Chọn GPU Type — ví dụ NVIDIA RTX PRO 6000 Blackwell.
- Chọn GPU sharing type — cách các Pod chia sẻ mỗi GPU vật lý trên node.
- Chọn GPU driver installation type:
- Pre-install (mặc định) — driver NVIDIA đã có sẵn trên node image. Chọn thêm Select a driver version. Hoạt động bất kể GPU Information ở Bước 1 bật hay tắt.
- Managed-install — GPU Operator tự cài driver cho bạn. Chọn thêm Select a driver version.
- Nếu GPU Information (Bước 1) đã chọn GPU Operator, form xác nhận "Active — the driver for this worker group is installed automatically."
- Nếu chưa, form cảnh báo "Not active yet — enable GPU Operator in GPU Software so the driver installs automatically" — quay lại Bước 1 và chọn GPU Operator.
- User-install — bạn tự cài driver; GPU sharing type tự động đổi thành None. Làm theo Hướng dẫn cài đặt GPU Driver trên Kubernetes để tự cài đặt.
- Chọn Type (flavor). Khác với Worker Group General, dropdown này liệt kê các flavor có sẵn đã gộp sẵn CPU, RAM, và số lượng GPU theo GPU Type đã chọn — ví dụ
112C768G_4RTXPRO6000_384G(4 × RTX PRO 6000, 112 CPU, 768 GB RAM). Bạn không cấu hình CPU/RAM riêng với số lượng GPU.
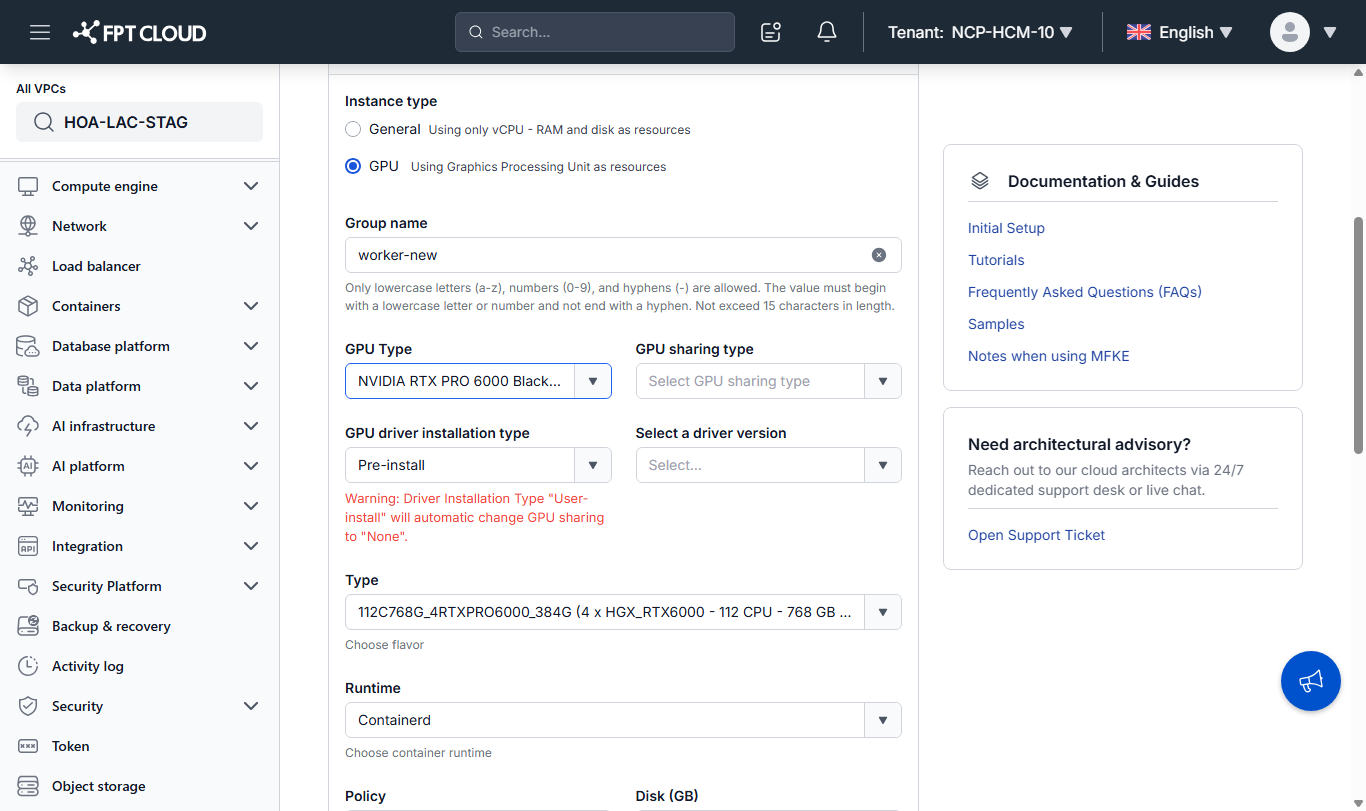
Chọn GPU Type và flavor cẩn thận ngay từ đầu — không hỗ trợ đổi flavor của Worker Group sau khi đã tạo. Nếu sau này cần GPU Type hoặc flavor khác, hãy tạo Worker Group mới rồi chuyển workload sang.
Scale Worker Group dùng GPU
Điều chỉnh số lượng worker node của Worker Group dùng GPU đã tạo dùng chung field Min node / Max node như mọi Worker Group khác, trong Node Pools → Edit Workers — xem Thêm Worker Group. Không có luồng scale riêng cho Worker Group dùng GPU.
Vấn đề thường gặp
| Vấn đề | Nguyên nhân / cách xử lý |
|---|---|
| Không thấy RTX PRO 6000 Blackwell trong danh sách GPU Type | Cluster đang chạy Kubernetes thấp hơn v1.33, hoặc bạn đang cấu hình base Worker Group (Worker group 1) — hãy thêm Worker Group thứ hai, hoặc nâng cấp cluster. |
| Muốn đổi GPU flavor của Worker Group đang chạy | Không hỗ trợ — xem Đổi flavor của Worker Group. |
| GPU sharing type tự đổi về None | Đây là hành vi mặc định sau khi đổi GPU driver installation type thành User-install — luôn ép GPU sharing type về None. |
Mẹo
- Quyết định GPU driver installation type trước khi tạo Worker Group — đổi sang User-install sau đó sẽ reset GPU sharing type, và dù sao cũng không đổi được flavor sau khi tạo.
- Nếu chạy workload GPU trên nhiều Worker Group, cấu hình GPU Information một lần ở cấp cluster thay vì để từng team tự cài GPU Operator.