Tổng quan CDC Service
CDC Service giữ cơ sở dữ liệu đích, search engine và storage luôn đồng bộ với cơ sở dữ liệu nguồn bằng cách truyền từng thay đổi qua Kafka theo thời gian thực. Với connector, bạn quyết định ghi nhận dữ liệu nào và chuyển dữ liệu tới đâu.
Change data capture là gì
Change data capture (CDC) theo dõi các dòng được thêm, cập nhật hoặc xóa trong cơ sở dữ liệu và chuyển mỗi thay đổi thành một sự kiện thay đổi. CDC connector đọc các thay đổi này từ log mà cơ sở dữ liệu vốn đã ghi.
| Cơ sở dữ liệu | Nơi connector đọc thay đổi |
|---|---|
| PostgreSQL | Write-ahead log (WAL), thông qua replication slot và publication. |
| MySQL, MariaDB | Binary log (binlog). |
| SQL Server | Tính năng change data capture của SQL Server 2016 trở lên, phiên bản Standard hoặc Enterprise. |
| Oracle | Redo log, thông qua Oracle LogMiner. |
| MongoDB | Oplog. |
Cách CDC Service hoạt động
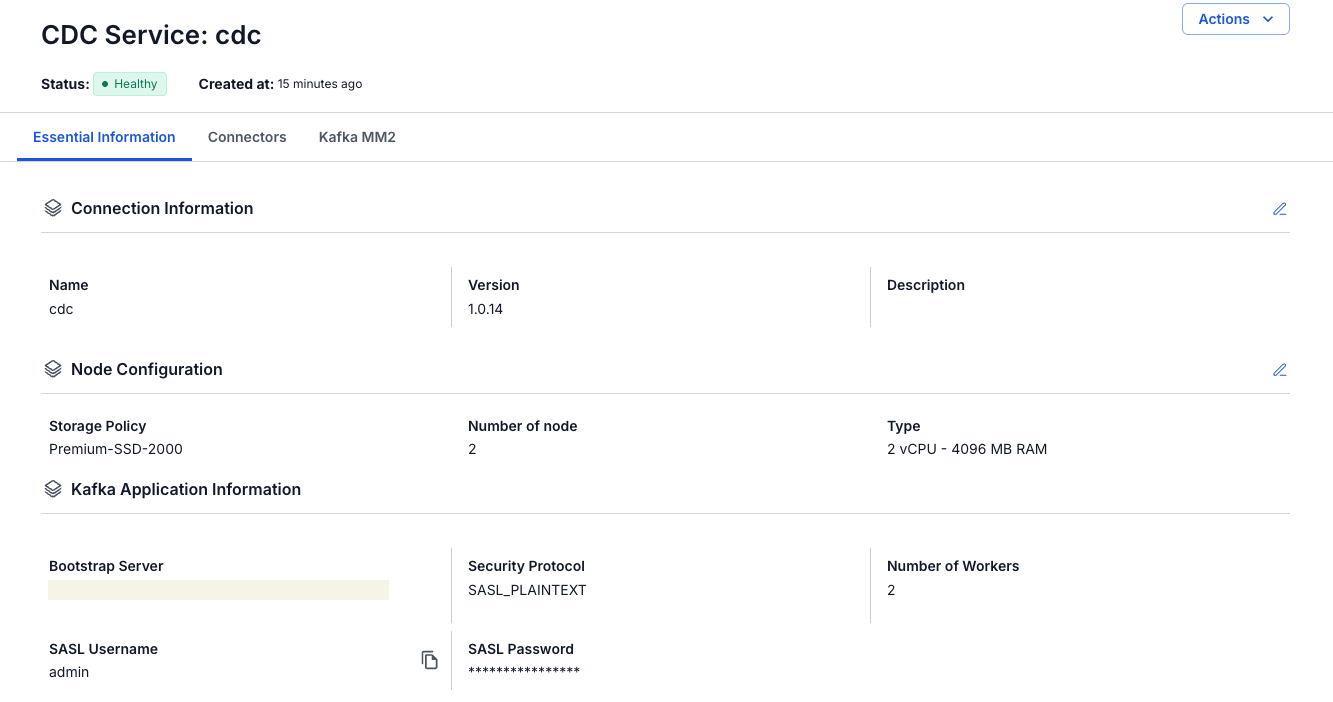
CDC Service là một service trong workspace Data Platform. Mỗi workspace chỉ có một CDC Service. Service chạy connector trên các node riêng và dùng một Kafka cluster mà bạn kết nối khi tạo service: cluster từ FPT Database Engine, hoặc cluster bạn tự cấu hình qua bootstrap server endpoint.
Source system → source connector → Kafka topics → sink connector → target system
Source connector và sink connector
Mỗi connector có Type và Database:
- Connector loại source ghi nhận thay đổi từ hệ thống nguồn và ghi chúng thành sự kiện thay đổi vào Kafka topic.
- Connector loại sink đọc Kafka topic và ghi bản ghi vào hệ thống đích, ví dụ cơ sở dữ liệu, search engine hoặc storage S3.
Mỗi connector chạy một hoặc nhiều task xử lý dữ liệu song song. Với sink connector, source connector Kafka và Kafka MM2, bạn đặt số task tối đa khi tạo.
Topic và topic prefix
Source connector ghi thay đổi của mỗi bảng vào một Kafka topic riêng. Tên topic gồm Topic prefix bạn đặt cho connector, tiếp theo là schema hoặc cơ sở dữ liệu, rồi tới tên bảng. Với prefix syncdata, schema inventory và hai bảng customer, order, connector PostgreSQL ghi vào syncdata.inventory.customer và syncdata.inventory.order. Với MongoDB, cơ sở dữ liệu và collection thay cho schema và bảng.
Sink connector đọc các topic bạn chọn và ánh xạ mỗi topic tới một bảng, một index hoặc một collection ở hệ thống đích. Xem Topic prefix, Topic và Map table.
Snapshot
Sự kiện thay đổi chỉ gồm những thay đổi xảy ra trong lúc connector chạy. Để sao chép cả dữ liệu đã có sẵn, source connector tạo snapshot.
- Initial snapshot. Khi bạn tạo connector, Mode quyết định connector sẽ snapshot dữ liệu có sẵn rồi mới ghi nhận thay đổi (initial), chỉ snapshot dữ liệu (initial_only), hay bỏ qua snapshot (no_data). MongoDB dùng latest và copy existing thay cho các giá trị này. MySQL và MariaDB xóa binlog cũ sau một thời gian, nên connector của hai hệ này bắt đầu bằng một snapshot nhất quán trước khi đọc binlog. Xem Chế độ snapshot.
- Incremental snapshot. Với source connector MySQL, MariaDB và PostgreSQL đã chọn Enable incremental snapshot khi tạo, bạn chạy snapshot vào lúc khác từ menu Snapshot của connector, trong khi connector vẫn truyền thay đổi. Xem Chạy incremental snapshot.
Kafka MM2
Kafka MM2 (MirrorMaker 2) sao chép topic từ Kafka cluster khác vào Kafka cluster của CDC Service. Kafka MM2 còn sao chép offset của các consumer group bạn chọn ở Kafka Group, để các consumer này chuyển sang cluster của CDC Service và đọc tiếp từ vị trí đã dừng. Bạn tạo Kafka MM2 bằng Create Kafka MM2 trên tab Kafka MM2 của service. Xem Quản lý source Kafka MM2.
Source connector Kafka cũng sao chép topic từ Kafka cluster khác vào cluster của CDC Service, nhưng chỉ sao chép dữ liệu của topic. Dùng source connector Kafka khi bạn chỉ cần dữ liệu, và dùng Kafka MM2 để chuyển topic cùng các consumer của topic.
Với Default Replication Policy, cả hai đặt tên topic đã sao chép theo dạng CLUSTER_ALIAS.TOPIC. Với Identity Replication Policy, cả hai giữ nguyên tên topic gốc.
Trạng thái connector
- Running: connector đang chạy và xử lý dữ liệu.
- Paused: connector không xử lý dữ liệu nhưng vẫn giữ trạng thái và cấu hình. Bạn có thể cho connector chạy tiếp.
- Stopped: connector và các task của connector đã tắt. Connector vẫn giữ cấu hình và offset, nên bạn có thể cho chạy tiếp.
- Failed: connector gặp lỗi và không thể tiếp tục xử lý dữ liệu.
Đây là trạng thái của connector. Healthy là trạng thái của chính CDC Service.
Để đổi trạng thái, xem Quản lý trạng thái connector.
Connector được hỗ trợ
| Hệ thống | Source connector | Sink connector |
|---|---|---|
| PostgreSQL | Source PostgreSQL | Sink PostgreSQL |
| MySQL | Source MySQL | Sink MySQL |
| MariaDB | Source MariaDB | Sink MariaDB |
| SQL Server | Source SQL Server | Sink SQL Server |
| Oracle | Source Oracle | – |
| MongoDB | Source MongoDB | Sink MongoDB |
| Kafka | Source Kafka | – |
| S3 | Source S3 | Sink S3 |
| ClickHouse | – | Sink ClickHouse (logs) thêm mỗi thay đổi thành một dòng mới trong bảng bạn tạo trước. Sink ClickHouse (Replication) giữ trạng thái hiện tại của từng dòng, cũng trong bảng bạn tạo trước. |
| Iceberg | – | Sink Iceberg áp dụng các thao tác update và delete của cơ sở dữ liệu nguồn. Sink Iceberg (logs) ghi nối tiếp mọi bản ghi. |
| OpenSearch | – | Sink OpenSearch |
| Elasticsearch | – | Sink Elasticsearch |
| Redis | – | Sink Redis |
Source connector Kafka sao chép topic từ Kafka cluster khác vào cluster của CDC Service. Source connector S3 đọc các file như CSV, TSV, Avro và XML từ Amazon S3 hoặc storage tương thích S3, ví dụ FPT Object Storage.
Quy trình điển hình
- Tạo CDC Service trong workspace và kết nối service với một Kafka cluster.
- Chuẩn bị cơ sở dữ liệu nguồn và tạo source connector, ví dụ source connector PostgreSQL.
- Tạo sink connector đọc các topic của source connector, ví dụ sink connector PostgreSQL.
- Kiểm tra Status và Snapshot Status của connector trên tab Connectors. Tham khảo Xem chi tiết connector và Chạy incremental snapshot.